今回は検索処理の学習備忘録の第2弾になります。
前回は検索対象のデータを効率よく取得するための転置インデックスについての内容でした。
転置インデックスは、「語」を含む書籍の「書籍ID」を管理するようなデータの保持方式でした。
なので、「語」をどのように抽出して管理するかが重要になってきます。
今回は、その抽出の仕方、すなわち
日本語をどのように切るか
についての記事になります。前回も少し触れましたが、今回は少し深ぼっていこうと思います。
なぜ日本語は切れないのか
まず、なぜそもそも切り方の議論をするのかと言う話をします。
言語の性質
英語やフランス語などの言語は分かち書きする言語です。
これはつまり、空白がそのまま「語」の境界となります。
日本語は分かち書きをしない言語です。英語における空白のような明示的な区切り記号がないため、境界を別の方法で作り出す必要があります。
これは日本語特有の問題ではなく、中国語やタイ語なども該当します。
検索エンジンにとっては空白で切れる言語の方が都合が良いため、日本語などの分かち書きをしない言語はまずこの問題を解決する必要が出てきます。
すなわち、どのように切るのかという議論がまず出てくるのです。
切り方には複数ある
例として「東京都水道局」という単語を語に分解する切り方を考えてみましょう。
「東京都水道局」と言う単語を意味の通る語に分割してみてください。と問うた時、全員一致の答えになるでしょうか?
ある人は、
東京都 / 水道局
と切るでしょう。ですが、以下のように切る人もいるでしょう。
東京 / 都 / 水道 / 局
どちらの切り方も目的によっては正しい結果です。ただ一概に「語」に切るといっても一つの単語に対して複数の切り方が存在し得るのです。
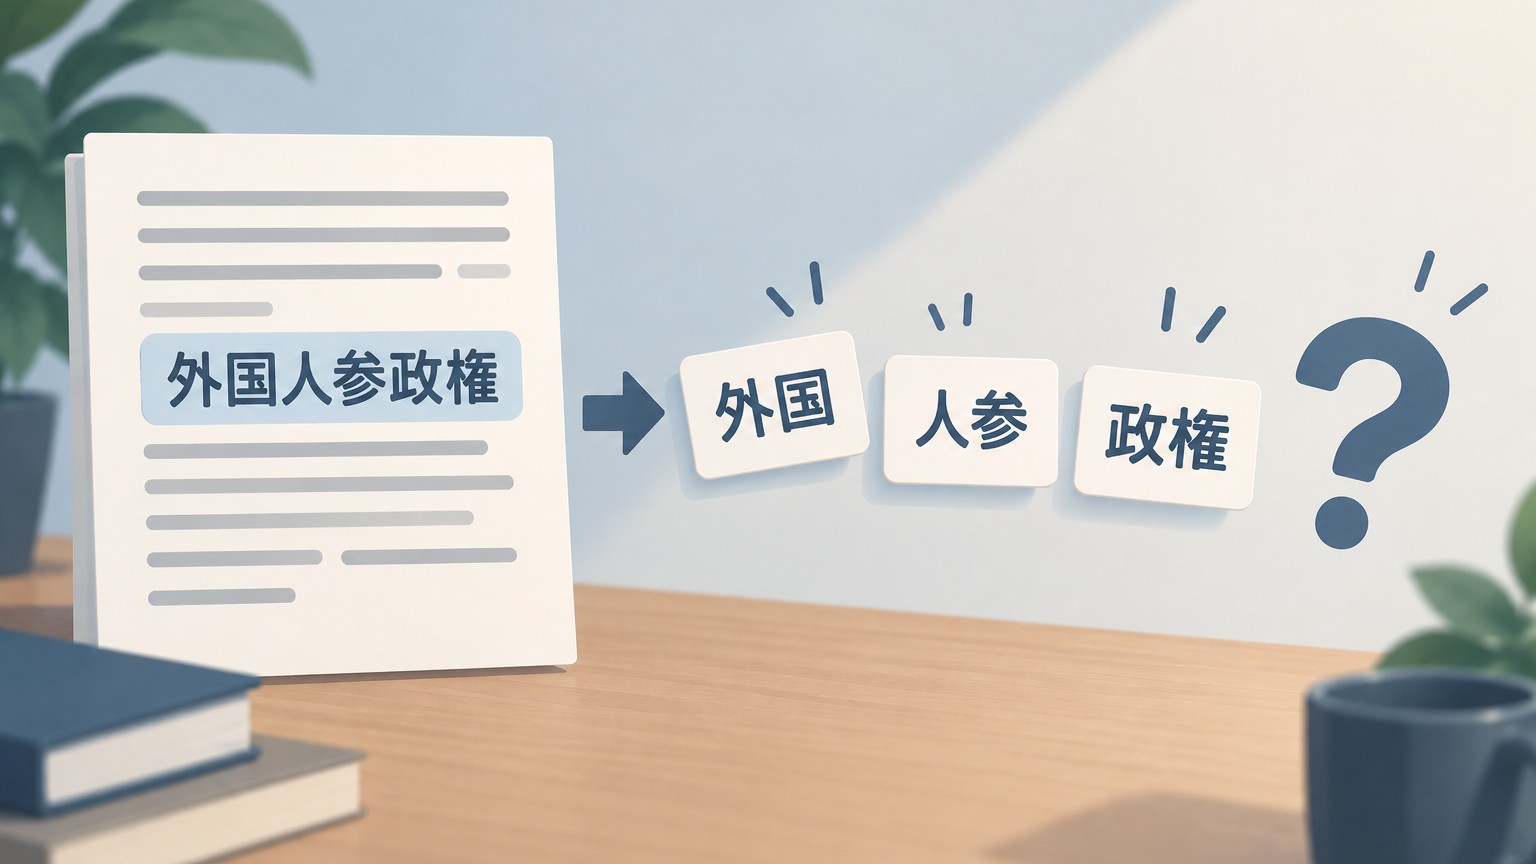
また、次の例として「外国人参政権」を切ってみます。すると、
外国 / 人参 / 政権
と言うパターンが出てきてしまいます。全く関係のない「人参」という語が生まれたことによって後の検索によって誤ヒットする可能性が出てきてしまうのです。
切り方を決める判断材料
文書を語に切る際に、切った後の語の粒度によって検索の精度や処理の重さが変わってきます。
例えば、文書をそのまま語として保存したとしましょう。その場合、
達人プログラマー
と言う検索で
達人プログラマー 第2版
が引けなくなります。
転置インデックスの索引として登録される語は「達人プログラマー 第2版」になるので「達人プログラマー」と言う検索だとヒットしない、つまり完全一致でないと検索できなくなってしまうと言うことになります。
かといって、極端に1語ずつ切って語を保存したとします。
その場合は、どんな検索でもヒットするような検索処理を実現できますが、語に対するposting listが大きくなり過ぎてしまいます。
この文書の切り方の判断としては、
語の粒度のどこに重きを向けるか
というのが一つの指標になってくるのです。
切り方には2つの流派がある
主な切り方は、
- 形態素解析
- N-gram
の2つです。
前回の記事にも載せましたが、改めて2つの切り方の特徴を以下にまとめました。
詳細に関しては、次節で述べます。
| 形態素解析 | N-gram(bigram) | |
|---|---|---|
| 何を根拠に切るか | 辞書(+ 語の繋がりやすさ) | 規則(N文字ずつずらす) |
| 切った結果 | 意味のある語 | 意味を持たない断片 |
| 語の個数 | 文書によって変わる(切ってみるまで不明) | 上限が「文字数 - 1」 で決まる |
| 準備 | 辞書の導入と更新 | 不要 |
| 辞書に無い語 | 切れない(未知語) | 影響を受けない |
| 語の境界 | 知っている | 知らない |
| 索引サイズ | 小さい | 大きい |
N-gramに関しては切る文字数は2とは限りません。
1文字ずつの場合はunigram、3文字ずつ切る場合はtrigramとなります。本記事は N = 2 として以降の話を進めます。
また、形態素解析、N-gramは排他ではありません。フィールドごとに使い分けをしているケースは普通に存在します。
形態素解析
形態素解析とは、
文を形態素の列に分け、それぞれに情報をつける処理
です。形態素とは、意味を持つ最小の言語単位です。
例えば、「食べられない」を形態素にきると
食べ / られ / ない
になります。「食べ」を「食」「べ」にきると意味が消えてしまうのでこれは形態素になりません。
形態素解析で文を切る場合は解析器と辞書を使います。
辞書はその名の通り、語(形態素)を管理しています。その辞書をもとに、文を切る作業を行うのが解析器になります。
解析器にはソフトウェアが、辞書には既存のデータがあります。
解析器には、MeCab・Sudachiなどがあり、辞書にはipadic・UniDic・NEologd・SudachiDictなどがあります。
どうやって切るのか
では本題に入りましょう。形態素解析の仕組みは次の3段階です。
- 辞書に載っている語を、当てはまる位置全てに並べる
- コストを付ける
- 合計コストが最小になる経路を1本選ぶ
それぞれの手順に沿って架空の解析器と辞書を用いたとして処理を追ってみましょう。
手順1では、まず辞書を引いてどのように切れるかの候補を列挙します。
「外国人参政権」を例としましょう。すると以下のような候補があがりました。
- 外国 / 人参 / 政権
- 外国 / 人 / 参政 / 権
- 外国 / 人 / 参 / 政権
- 外国 / 人参 / 政 / 権
- 外 / 国 / 人参 / 政権
- 外 / 国人 / 参政 / 権
このように候補が格子状に並ぶため、これをラティスと呼びます。
ここで、「外国人 / 参政権」と言う候補が上がらなかったのは辞書に「外国人」、「参政権」という語が載っていなかったからです。
どの辞書を用いるかによってラティスは変わってくることに注意してください。
手順2では、ラティスに上がった各候補のコストを算出していきます。
コストには2種類あります。
単語コスト
その語そのものの出現しにくさを表します。これは辞書に既に載っているものになりす。
連接コスト
直前の語との並びにくさを表します。品詞の組み合わせごとの表を辞書が持っており、これを参照します。
今回の例では以下のようになりました。
| 開始位置 | 候補 | 単語コスト | 品詞 |
|---|---|---|---|
| 1文字目 | 外国 | 2300 | 名詞、一般 |
| 外 | 6300 | 名詞、一般 | |
| 2文字目 | 国人 | 8600 | 名詞、一般 |
| 国 | 7800 | 名詞、一般 | |
| 3文字目 | 人参 | 5600 | 名詞、一般 |
| 人 | 7100 | 名詞、一般 | |
| 4文字目 | 参政 | 3300 | 名詞、サ変接続 |
| 参 | 7000 | 名詞、一般 | |
| 5文字目 | 政権 | 3700 | 名詞、一般 |
| 政 | 6900 | 名詞、一般 | |
| 6文字目 | 権 | 8600 | 名詞、一般 |
連接コストに関しては、今回はどれも名詞から名詞へのつながりなのでほぼ一定になります。
今回は仮に +50 で固定としておきましょう。
そして最後の手順3です。
これをもとにラティスに上がった候補の合計コストを算出します。
| 候補 | 合計コスト |
|---|---|
| 外国 / 人参 / 政権 | 11700 |
| 外国 / 人 / 参政 / 権 | 21450 |
| 外国 / 人 / 参 / 政権 | 20250 |
| 外国 / 人参 / 政 / 権 | 23550 |
| 外 / 国 / 人参 / 政権 | 23550 |
| 外 / 国人 / 参政 / 権 | 26950 |
今回は、コストの最小値になるのが
外国 / 人参 / 政権
になりましたので、これが今回の切った結果になります。
実装例
では形態素解析を簡単に実装してみましょう。
ただ、上記の通り形態素解析に用いる解析器と辞書はソフトウェアとデータがあるのでロジカルな実装例にはならないことをご了承ください。
ここでは解析器に、MeCabを、辞書に、ipadicを用いて実装します。
import MeCab, ipadic

mecab = Mecab.Tagger(ipadic.MECAB_ARGS + " -Owakati")
print(mecab.parse("外国人参政権"))

# → 外国 人参 政権
非常に簡単な実装ですね。
コード自体はライブラリをimportして使用しているだけですが、中で実行している処理は上記に記載した手順で行われています。
また、前述の通り、同じ解析器を用いても辞書が違えば異なる結果になることもあります。
コード自体は数行で動きますが、動かした後に残る問題は辞書になると言うことです。
ここで問題なのが、ipadicやNEologdといった主要な辞書は更新が止まっているということです。
つまり2026年の新語はどちらの辞書にも入っていません。書籍検索となるとこの問題は他人事では無いことに注意が必要です。
中には更新が続いている辞書もあり、それらを使うことが有効な手段ですね。
更新が続いている辞書(2026年9月現在)↓
- UniDic:国立国語研究所
- SudachiDict:Sudachiの辞書
強みと弱み
強み
- 語の境界を知っている → 例えば、東京都をMeCabで切ると、東京 / 都 になるので「京都」という検索にヒットしません。冒頭で述べた「京都」で「東京都」がヒットする問題が起きません。
- 活用を吸収できる → 「読んだ」をMeCabで切ると、読ん / だ に切られ、「読ん」の原形として「読む」が取れます。索引を原形で入れておけばどの活用で検索しても引けるようになります。
- 索引が小さい → L文字の文書の posting list を作る上でbigram の場合は上限値が L - 1 になるのに対して、形態素解析の場合は語が長いほど posting list が小さくなります。概算で L ÷ w(平均語長)になります。
弱み
- 辞書にない語が切れない → カタカナが続くと塊のまま1語になることが多いです。
- 複合語を1語にして取りこぼす → 「京都新聞社」を切れずにそのまま登録される場合があります。そうすると「京都」という検索にヒットしなくなってしまいます。切る粒度を設定で変えることができます。
- 辞書のメンテナンスに依存する → 実装例に書いた通りです。
N-gram
N-gramとは
N-gram = 連続するN個の並び
という意味です。
区切る文字数Nによって名称が変わり以下のようになります。
| N | 呼び方 | 外国人参政権を切ると |
|---|---|---|
| 1 | unigram | 外 / 国 / 人 / 参 / 政 / 権 |
| 2 | bigram | 外国 / 国人 / 人参 / 参政 / 政権 |
| 3 | trigram | 外国人 / 国人参 / 人参政 / 参政権 |
どうやって切るか
上記で簡単に触れましたが、
N文字ずつ、1文字ずつずらして切り出す
これだけです。
形態素解析と比べると以下のようになります。
| 形態素解析 | N-gram | |
|---|---|---|
| 辞書を引く | 引く | 引かない |
| ラティス | 複数 | 1通りしかない |
| コスト計算 | する | しない |
| 経路選択 | する | しない |
これからわかるように、N-gramでは形態素解析で行ったようなステップは一切ふまず、単純に機械的に切るやり方になります。
実装
機械的な切り方なので実装も、ライブラリなどは使わずにシンプルに実装できます。
# ここでは2文字で切るbigramを実装
def bigram(text):
  L = len(text)
  return [text[i:i+2] for i in range(L - 1)]

print(bigram("外国人参政権"))
# → ['外国', '国人', '人参', '参政', '政権']
強みと弱み
強み
- 未知語という概念が存在しない → 辞書を引かないので「辞書に無い語」が原理的に発生しません。
- 準備もメンテナンスも不要 → 辞書の更新が止まるという問題も発生しません。
- 結果が決まる → 切り方が1通りなので環境や辞書のバージョンで結果が変わりません。
弱み
- 索引が膨らむ → 前節のとおり、概ね平均語長のぶん膨らみます。
- 語の境界を知らない → 東京都が、東京 / 京都 になるので「京都」の検索で「東京都」がヒットします。
- 活用を吸収できない → 「読ん」と「読も」は別の文字列でしかなく、原形に寄せる手段がありません。
- 1文字のクエリが引けない(N ≧ 2 の場合) → 「机」のような1文字では bigram が1つも作れず、索引を引く手段がありません。
今回は bigram を採る
まず、前提ですが今回学習している検索処理は個人開発したアプリケーションの書籍検索に適用するためです。
索引に入れるのは、書名、著者名、読みになります。
そして、要件として'読み'で検索できるようにします。「たつじんぷろぐらまー」で「達人プログラマー」がヒットするようにします。
また、書籍データのソースにopenBDを使用します。これはopenBDがカタカナの読みを持っているためこれを活用します。
その上で、今回は
bigram
を採用します。その理由をここでまとめます。
理由1:読み検索が形態素解析では成立しない
「たつじんぷろぐらまー」で検索した場合、まず「タツジンプログラマー」とカタカナに正規化します。
そして、この入力に対して形態素解析を行うとカタカナは一塊になり(辞書にないため)クエリとしては「タツジンプログラマー」そのままになります。
ここで、索引側のデータに関してはopenBDには読みデータが空白区切りで保存されています。
具体的には
タツジン プログラマー
と登録されています。これに対して形態素解析を行うと
タツジン / プログラマー
となるので「タツジンプログラマー」というクエリ文字列でヒットしなくなってしまうのです。
bigramの場合は索引側にもクエリ側にも同じ規則が適用されるのでこのような問題は発生しません。
理由2:書名は未知語の塊
形態素解析の場合は、解析の際に使用する辞書に依存します。
辞書にない語は意図した索引が作成できないので、年々新しい語が更新されるであろう書籍データにはあまりにも不向きです。
理由3:bigramの場合索引が肥大するが許容範囲内
bigramの弱みとして索引データが肥大することがありますが、今回のデータの規模だと許容範囲内です。
理由1、2と引き換えなら払える程度の話です。
理由は上記の3つを挙げましたが、実質理由1が決定打になっています。
今回の検索処理が読みで検索するという要件があるため形態素解析の選択肢は必然的になくなる話でした。
また、誤ヒットの問題ですが、候補が出た後に実際の文字列で確認すれば落とせるので大きな問題にはなりません。(前回記事参照)
まとめ
今回は、日本語をどのように切るかという話でした。
切り方を考える際にポイントだったのが
索引側とクエリ側で同じ規則が適用されるか
というところでした。
形態素解析は決して切り方として弱い方式であったわけではありません。
今回の要件として、openBDを使用することがあり、openBDは読みを空白区切りのカタカナで持っていたことがありました。
索引側は空白区切りの整形されたデータ、クエリ側は利用者が続けて打った文字列。形態素解析はこの入力の形の違いに結果が左右されるため、両者の切り方が揃いませんでした。
要件によっては形態素解析の方が優位になることはあるでしょうし、現にN-gramと形態素解析はハイブリッドで使用されているケースもあります。
今回の学習を通して、語の切り方について2つの方式を理解することができました。
両方の強み弱みを理解した上で、要件にあった方式を選べるようになりたいと思いました。
最後までご愛読ありがとうございました。
