今回は転置インデックスについての学習備忘録を記事にまとめたいと思います。
なぜ唐突に転置インデックスの話が出てきたのかという話ですが、詳細は省きますが個人開発でリリースした「Shelfie」の書籍検索の検索処理を自分で実装してみようと思ったところから始まります。
検索処理を自前実装(AI開発ですが)するにあたって、技術選定をしていたのですがあまりにも事前知識がないためそのまま学習ブログにしてしまおうと思ったことが今回の記事の執筆に当たった直接の理由になります。
今回はそのはじめとして転置インデックスにフォーカスを当ててまとめます。もちろん今後もいろんな技術について学習ブログをあげていきます。
自分も検索処理に関しては初学者も初学者なので、全く知識のない読者の方も読める内容になるようにまとめていきたいと思います。
転置インデックスとは
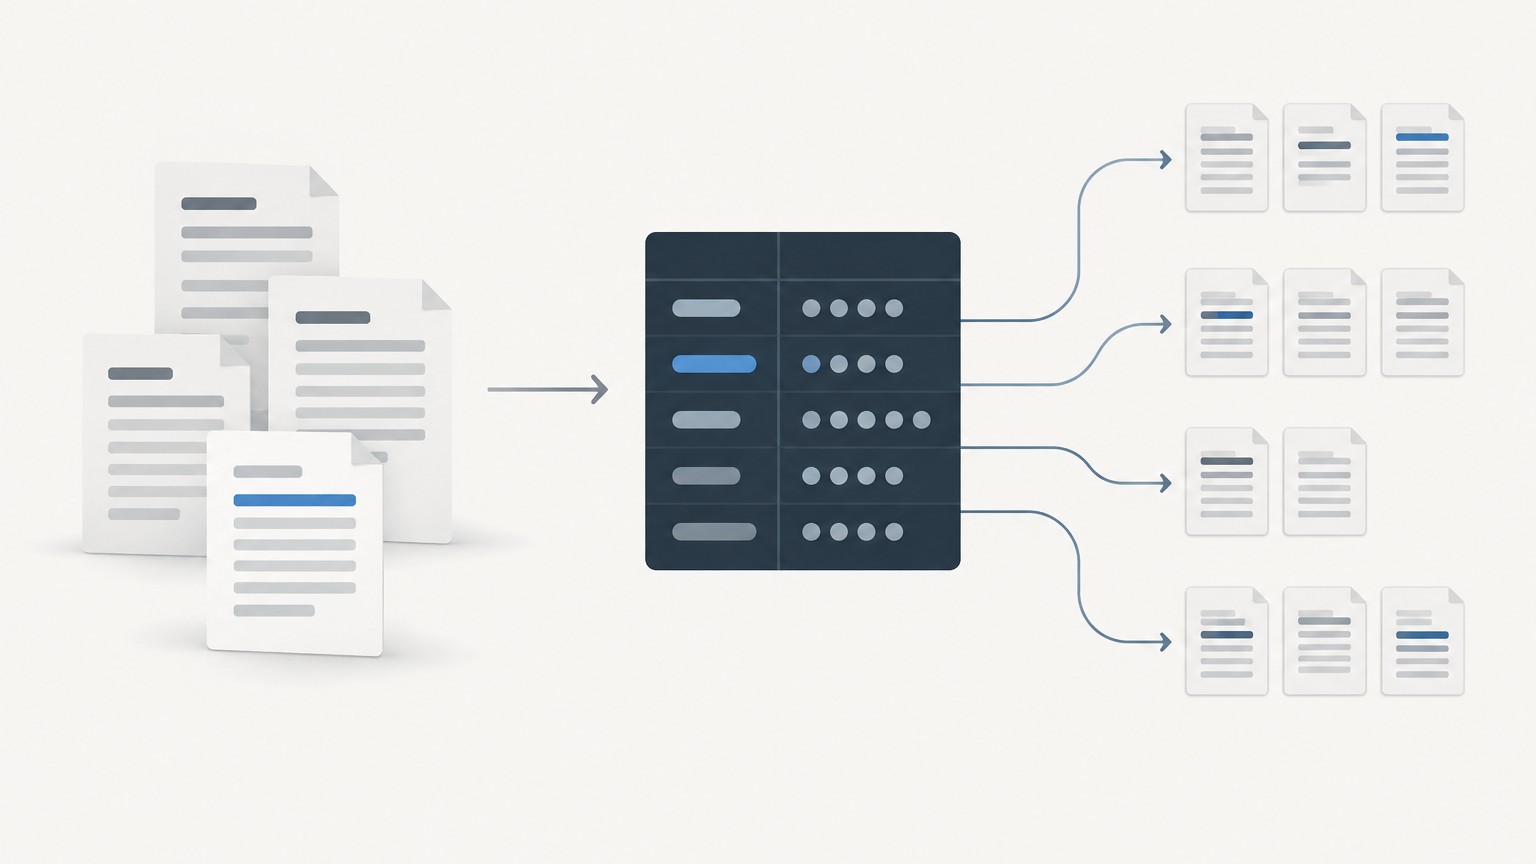
まずそもそも転置インデックスとは何かですが、一言でいうと次になります。
「語 → その語を含む文書の一覧」の対応表
検索したい語を引くと、その語を含む文書の文書IDを返す表のことを指します。
なぜ転置なのか
そもそも素直にデータを作成するとなると次のようになると思います。
| 文書ID | 書名 | 含まれる語 |
|---|---|---|
| 1 | リーダブルコード | リーダブル、コード |
| 2 | 良いコード悪いコード | 良い、悪い、コード |
| 3 | Go言語による並行処理 | Go言語、並行処理 |
| 4 | Go言語でつくるインタプリタ | Go言語、インタプリタ |
普通に書籍データを作成すると、「書籍 → その書籍に含まれる語」の対応でデータを保存すると思います。
この対応は人間にとっては自然な対応表ですが、検索には向かない対応になります。
例として、「Go言語」を含む書籍を検索する場合は1行目から順に探索して見ていくしか手段がないからです。
そこで向きをひっくり返します。
| 語 | 文書ID |
|---|---|
| コード | 1, 2 |
| リーダブル | 1 |
| 良い | 2 |
| 悪い | 2 |
| Go言語 | 3, 4 |
| 並行処理 | 3 |
| インタプリタ | 4 |
この対応表を作成することで、「Go言語」を含む書籍は「文書IDが3と4の書籍」ということが即座にわかります。
これが転置インデックスです。
なぜ転置インデックスが必要なのか
転置インデックスを作成する利点は1節でも軽く述べましたが、転置インデックスがどのような場面で必要なのかという話をしましょう。
まずは、全件走査と転置インデックスを比較してみましょう。
全件走査
全件走査する場合には検索処理にかかる時間はデータ全体の件数に比例します。
つまり、データが上の表のような数件であれば処理にかかる時間はわずかですが、例えばデータが100万冊に増えた場合は検索処理に100万冊分探索することになるということです。
転置インデックス
転置インデックスの場合は検索処理にかかる時間はその語を含む書籍の件数に比例します。
これは例えば、「Go言語」にヒットする書籍が2件しかないならば、書籍全体データが4冊だろうが100万冊だろうが処理時間は変わりません。
以上のように、ただ転置インデックスを使うと処理が速くなるというわけではなくそもそも処理の対象が異なるということに注意してください。
また、全件走査と転置インデックスは作る時と引く時の処理も異なります。
全件走査には作る時が存在せず、検索処理で毎回全てを走査します。
対して、転置インデックスはあらかじめ対応表を作成しておきます。この処理は全文書をなめる処理になるので重い処理にはなりますが一度作っておけばその後の検索処理には何万回でも使い回しができます。
逆にいうと検索が一回しか行われないような処理の場合は、索引を作るだけ処理を損するので適さないケースもあります。
転置インデックスが適さないケース
LIKE 'Go言語%'
のような前方一致検索の場合はB-treeのインデックスが効くので転置インデックスは必要ありません。
B-treeは辞書と同じで先頭の文字から順に並べて絞り込む構造なので前方一致検索の場合はB-treeのインデックスが適切でしょう。
逆に、
LIKE '%Go言語%'
のような部分一致検索の場合は、B-treeが効かないので転置インデックスの出番でしょう。
posting list —— 転置インデックスの本体
ここで転置インデックスを用いた検索処理の具体的な話をします。
その前に、1節で用いた表を思い出してそれらの表に出てくる単語には用語がついているのでそれをまず説明します。
| 英語 | 日本語 | 中身 |
|---|---|---|
| term | 語 | 索引の見出し |
| posting | ポスティング | (語、文書ID)の組ひとつ |
| posting list | ポスティングリスト | ある語に対応する文書IDの並び |
| dictionary / lexicon | 辞書 | 語の一覧。ここから posting list を引く |
検索の実体としては、以下の2ステップのみです。
- 辞書で語を引く
- ぶら下がっている posting list を読む
ここで検索処理の核になってくるのが、posting listを昇順でもつことです。
posting list を昇順でもつ理由
posting list を昇順でもつことが後の処理を支えているのですがそれが以下の3つです。
- 複数の posting list を同時になめることによって共通部分が取れる(AND検索)
- 隣との差が小さい数字になるので圧縮が効く
- 新しい文書のIDは常に一番大きいので追記が末尾で済む
2に関しては後述します。3に関しては説明不要だと思うのでAND検索に関して掘り下げましょう。
AND検索のやり方
書籍が数十冊登録されているとして、以下の posting list があるとします。
- 「Go言語」:3, 7, 12, 20, 31
- 「入門」 :1, 7, 20, 45
両方に含まれているのは7, 20です。これをどのように取得するかですが、シンプルに考えるとそれぞれの posting list から 一つずつ取り出して比べていけばいいので 5 × 4 で20回処理すればいいでしょう。
ただ、 posting list が昇順で並んでいる場合は処理を工夫することで処理時間を短縮することができます。
実装例
i = j = 0

result = []

while i < len(a) and j < len(b):
  if a[i] == b[j]:
    result.append(a[i])
    i += 1
    j += 1
  elif a[i] < b[j]:
    i +=1
  else:
    j += 1
やり方としては以下です。
2本のリストに先頭を固定して、小さい方を進めていく
常にどちらかの先頭をみているので posting list を後戻りして見ることはありません。なので今回の件で言うと多くても9回しかみません。
一般的に2つの posting list の長さが N, M の場合は計算量は O(N + M) です。
この処理は posting list が昇順でないとできない処理です。順序がバラバラだと、どちらを進めるべきかを判断できないため「Go言語」の5件について結局「入門」の4件を全部照合することになるので計算量は O(N × M) になります。
今回の5件と4件だと大差はありませんが、1000件と800件ならば
80万回 vs 1800回
なので大きな差になります。
OR検索とNOT検索
OR検索に関しては、AND検索の処理と同じで一致したものだけ拾う代わりに片方にしかないものも拾う処理にすれば良いので **O(N + M)**で処理できます。
i = j = 0

result = []

while i < len(a) and j < len(b):
  if a[i] == b[j]:
    result.append(a[i])
    i += 1
    j += 1
  elif a[i] < b[j]:
    result.append(a[i])
    i +=1
  else:
    result.append(b[j])
    j += 1
result.extend(a[i:])
result.extend(b[j:])
ただし、NOT検索は話が変わってきます。posting list では「Go言語 を含まない 本」を作ることができません。
「全部の本」の一覧から引き算をする必要があるので、結局全件走査の処理が必要になることになります。
なので、検索エンジンではNOT検索を実装する場合は、NOTを単独で受け付けずに A AND NOT B のような形で受け付けているものが多いです。
語をどう切るか
これまでで、転置インデックスを用いた検索処理に関して大枠をまとめましたが重要な話をしていませんでした。
それは、「語」をどのように扱うのかという話です。
上の例で話していたものは、「コード」や「Go言語」など当たり前に単語として登録していましたが実際はこの処理を機械的に実装する必要があります。
英語の場合は空白で切ることで実現できますが、日本語の場合はそうはいきません。
では、日本語で「語」の生成に関する処理はどのように行うのでしょうか。
2つの方式があります。
| 形態素解析 | N-gram(bigram) | |
|---|---|---|
| 切り方 | 辞書と文法で切る | N字ずつ機械的に切る |
| 「並行処理」 | 並行 / 処理 | 並行 / 行処 / 処理 |
| 必要なもの | 辞書(MeCab / Sudachi) | 何も要らない |
| 弱点 | 辞書にない語が切れない | 索引が膨らむ / 誤ヒットする |
今回はbigram(2-gram)を採用します。
理由としては、辞書がいらないことが1番の理由になります。転置インデックスの構造に集中したいので切り方の準備に手間がかからない方式をとりました。
どちらがいいのかは検索の質を決める大きな論点ではありますが、ここでは深掘りせず必要になった時にまた別記事にしたいと思います。
bigramの性質
1. ポスティングの数が文字数で決まる
1つの文書から出る bigram の個数の上限値は「文字数 - 1」です(同じ bigram が複数回出ても posting list には1件しか入りません)。
これが機械的に決まるので posting のサイズを文字数から計算することができます。
形態素解析だと語数が文書によって変わるので、機械的な計算はできず実際に切ってみるまでわかりません。
2. 誤ヒットする
有名な例として、「京都」で検索すると「東京都」がヒットするという話があります。
「東京都」を bigram に切ると、
東京 / 京都
になります。「京都」という bigram が入るのでこれが誤ヒットの要因となります。
posting list は「その語がどこにあるのか」という情報を持っていないので「東京」、「京都」がどう並んでいるのかを索引側からは検証できないのです。
なので最後に、候補だけ実際の文字列で確認します。候補は数件なので、これは全件走査ではありません。
索引はどれくらい大きくなるのか
最後に転置インデックスのサイズについてまとめます。
なぜサイズの話をするのかというと、理由は単純で転置インデックスはシンプルに追加のデータになります。
転置インデックスがメモリに載るかどうかで速度が変わります。
前述の通り、索引は作るのが重い処理になりますので作り終えてからメモリに載りませんでしたとなるのは本末転倒なのです。
素朴にもつとどうなるか
以下の定義のもと、サイズを計算してみましょう。
- 書籍:172万件(openBDの書籍データを取得するとした場合)
- 検索対象の文字数:一冊あたり平均80文字
まず、一冊あたりの posting の上限値は「文字数 - 1」なので
- 一冊あたりの posting 数 ≒ 79
- 総 posting 数 ≒ 172万 × 79 ≒ 1.4億
文書IDを4バイトの整数でもつ場合
- 1.4億 × 4バイト ≒ 540MB
つまり索引だけで540MBになります。ちなみに元データは(172万 × 80文字 × 3バイト)約400MB程度です。
索引の方が本データより大きくなります。
差分で管理する
posting list は前述の通り昇順でもっているのでこれを利用してデータサイズを圧縮できます。
posting_list = [3, 7, 12, 20, 31]
このようなデータがある場合2つ目以降の要素を前の要素の差分で管理するようにしましょう。
posting_list = [3, 4, 5, 8, 11]
元のデータは足していくだけで復元できるので情報を失わずに圧縮できます。
元のデータは文書IDが172万まで伸びますが、差分は数十〜数百に収まることが多いです。
この圧縮方法をdelta encodingといいます。
小さい数字を短く書く
せっかく差分が小さくなったのに4バイト固定で持っていたら意味がありません。(4を4バイトでもつのは無駄)
全て1バイトでもつとしたら0〜255までしか扱えません。かといって数字ごとにバイトサイズを変えるとした場合は読む側が大変になります。
そこで可変長バイトのVByteというものを使います。
これは1バイトのうち7ビットをデータに使い、残りの1ビットを「まだ続く」のフラグに使用します。
例えば、「4」を扱う場合はもちろん1バイトで足ります。
なので8ビットのうちの先頭を「0(続きなし)」にして、後ろの7ビットで「4(0000100)」にします。
そして「300」を扱う場合は1バイトではたりませんので、以下のようにします。
300 = 100101100(9ビット)なので
- 下位7ビット → 0101100 ( = 44)
- 残り → 0000010 ( = 2)
と分解し、
- 1バイト目:「1(まだ続く)」+「0101100」 → 10101100
- 2バイト目:「0(続きなし)」+「0000010」 → 00000010
復元は重みをかけて足すことで実現できます。(44 + 2 × 128 = 300)
これを用いることで以下のような対応でバイト数を節約できます。
| 値の範囲 | バイト数 |
|---|---|
| 0 ~ 127 | 1バイト |
| 128 ~ 16,383 | 2バイト |
| 16,384 ~ 2,097,151 | 3バイト |
172万は3バイトで収まります。また、delta encodingと合わせることで多くの場合で1バイトで事足りることになり、差分が大きいものだけ2 ~ 3バイトになります。
なぜよく効くのか
この圧縮方法がなぜ効くのかという話をします。
上記の圧縮方法ですが、圧縮の効き方には偏りがあります。それは差分の大きさによるからです。
平均の差分をざっくりと計算すると
平均差分 = 全文書数 ÷ posting list の長さ
になりますので posting list が長いほど差分は小さくなり、posting list が短いほど差分は大きくなります。
つまり、容量を食っている長い posting list (頻出のbigram)ほど差分が小さい分よく圧縮されます。
なので全体としてはこの圧縮方法がよく効くのです。
結論
delta encoding と VByte を適用した後の転置インデックスのサイズは、200MB前後になることが予想されます。
下限は全て1バイトで済む場合なので、172万件 × 79ポスティング × 1バイト ≒ 140MB
上限は全て3バイトになる場合なので、172万件 × 79ポスティング × 3バイト ≒ 410MB
です。実際は長いリストが1バイト側に寄るので、200MB前後に落ち着くだろうと踏んでいます。
540MBだとメモリに載せるか迷うサイズですが、200MBという載せてもいいという判断ができるくらいのサイズまで圧縮することができました。
まとめ
今回は検索処理の学習ということで転置インデックスについてまとめました。
転置インデックスについての概要を学べただけでなく、その中でどのような技術を用いて実装すればいいのかも落とし込むことができました。
今回まとめた内容が全てではなく、他にも
- 順位づけ(実際の検索はどの順で出すか)
- 更新処理(索引を作り直すのか否か)
- 位置情報(posting list に何文字目に出たかまでを持たせる)
などの話もあるみたいです。
今回の話で、重要だったことは
posting listを昇順でもつこと
ですかね。この事実を元に解決できる問題が多々あったと思います。
そしてさらに重要なのが
転置インデックスが速いのは、処理が速いからではなく、見る対象が減るから
ということです。ただ闇雲に転置インデックスを使おう!ではなく、用途にあった扱い方をすることが何事も重要だということも学ぶことができました。
最後までご愛読ありがとうございました。
